当一台 TOR交换机 要装下 33M 条 BGP 路由:解读阿里云 HPN Pivot 路由架构
HPN Pivot 的解法不是压缩路由,而是把 infra 路由和业务路由拆到两条不同的分发通道上——前者继续逐跳 BGP,后者交给集中式容器化 RR。
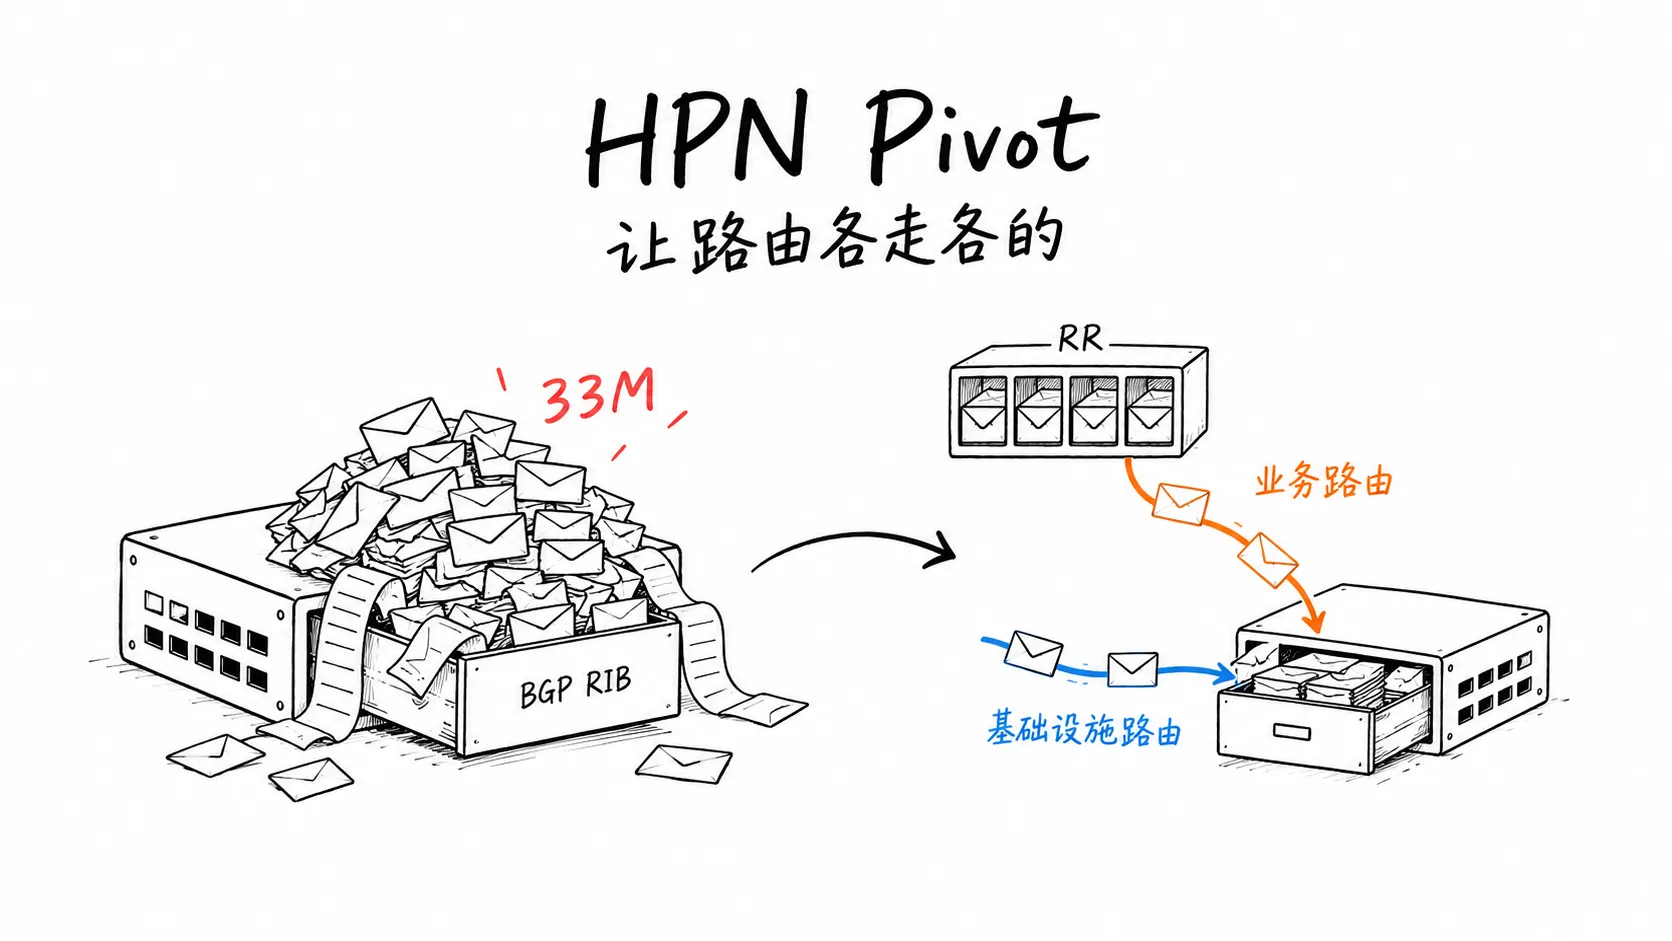
一句话结论:在 2 层 CLOS 把交换芯片 radix 堆到512以上之后,先撑不住的不是交换芯片的 FIB,而是 TOR 交换机的 BGP RIB。HPN Pivot 的解法不是压缩路由,而是把 infra 路由和业务路由拆到两条不同的分发通道上——前者继续逐跳 BGP,后者交给集中式容器化 RR。将单台 TOR 的 BGP RIB数量从 33M 量级压回 几百K 量级。
刚刚举行的OCP Global Summit上,阿里云网络研发团队在 Networking 分会场介绍了其专为超大规模智算网络集群设计的 HPN Pivot路由架构,演讲标题是 Beyond Traditional BGP: Decoupling Route Distribution for Large-Scale AI Clusters at Alibaba。并表示该架构已经在阿里云智算集群规模部署,将支撑智算网络集群从10W卡向百万卡的演进。
看过完整session后,个人认为HPN Pivot最大的价值不在于提出了新协议,而是在不依赖新硬件、不大改控制面协议、不牺牲产品能力的前提下,通过对路由系统架构创新,给出了支撑智算网络集群规模由十万卡向百万卡演进的方案与实践。
1. 背景:智算集群的规模算术
1.1. 为什么一定要把单网络集群做大
AI对网络规模的需求没有停下来的迹象。2023 年,业界以万卡集群为标杆。2025 年,10 万卡量级的集群已经进入交付。再往后,50 万卡乃至百万卡量级的单集群,也已经进入行业的建设规划。
对网络而言,规模本身即是价值来源。Metcalfe’s Law 的表述是:一张网络的价值与接入节点数的平方成正比。这条定律在智算集群里有一个直接的对应物。集合通信的规模越大,可编排的并行策略空间就越大。单任务能切到的 GPU 数量上限也随之抬高。
对云资源售卖场景,做大单集群规模还有两项额外收益:
- 可调度资源池变大。产品支持的单用户最大规模随之提升,大任务不必再跨集群拼接。
- 资源碎片变少。同一资源池内的空闲卡更容易凑成连续可用的规格,售卖率随之改善。
这两点决定了云服务商有持续做大单集群的内在动力,而不是”够用就行”。
1.2. 2 层 CLOS 把 radix 用满之后
网络层数越少,ECMP 哈希冲突的概率越低,端到端时延也越低。因此智算网络普遍倾向压层数:能用 2 层,就不用 3 层。
阿里云在 SIGCOMM 2024 公开的 HPN 架构就是 2-tier、dual-plane 设计,单 Pod 可互联 15K GPU。同一篇论文提出用 dual-ToR 替代传统的 single-ToR。压层数的代价是:单台交换机的 radix 必须做到极致。
按公开演讲的设定,取一台 radix 为 512 的交换芯片做 2 层 CLOS,收敛比 1:1:
| 项 | 数值 | 说明 |
|---|---|---|
| TOR 下行端口 | 256 | radix 512 的一半 |
| TOR 上行端口 | 256 | 即 Spine 数量 m = 256 |
| TOR 数量 n | 512 | 每台 Spine 512 下行 |
| 可接入网卡数 | 256 × 512 = 131,072 | 每网卡 1 个 IP |
| 单台 TOR 自带业务路由 | 256 | 对应 256 张下联网卡 |
| 集群业务路由总量 | 131K | 即 service route 总量 |
| 集群 infra 路由总量 | m + n = 768 | Spine 与 TOR 各一条设备地址 |
这张表里,131K 与 768 之间的悬殊差距,是后面全部讨论的起点。
2. 挑战:瓶颈不在 FIB,在 BGP RIB
2.1. 33M 是怎么算出来的
BGP 已经是大规模数据中心网络的默认控制面协议。而 BGP 的逐跳传递语义决定了一件事:TOR 会从每一台 Spine 都学到集群内的全量业务路由。
于是单台 TOR 的 BGP RIB 条目数是:
131K(全量业务路由) × 256(Spine 数量) = 33M BGP path这里统计的是 BGP path,不是 FIB 表项。33M 条 path 经过最优路径选择与多路径安装之后,落到交换芯片 FIB 里的仍然是 131K 条前缀。所以:
131K 对 FIB 是可承受的,33M 对 BGP RIB 是不可承受的。
2.2. 三个直接后果
33M 条 BGP path 带来的问题不止是内存占用。
- 内存与 CPU。每条 path 都要在 RIB 中保存属性、AS_PATH、community 等元数据,并参与最优路径计算。千万级 path 的 BGP 进程,其内存占用与 CPU 开销都会脱离交换机的常规设计假设。
- 收敛性能恶化。网络内任何一次链路或设备状态变化,都要在这个规模的 RIB 上触发重新计算。规模本身会放大单次事件的收敛时延。
- 隔离再入网基本不可行。这是运维视角最痛的一点。TOR 被隔离后再入网,需要重新完成 33M path 的全量学习。这个时间长度会让传统的”隔离—维修—回灌—验证”变更流程失去可操作性。
2.3. 为什么不能在 TOR 层做路由汇聚
在线下 IDC 的独占环境里,这个问题有成熟解法。做法是给每台 leaf 交换机规划固定的 IP 网段,leaf 向上只通告汇总网段,网卡明细路由不出 leaf。汇聚一做,上游的路由规模立刻塌缩。
但对需要以裸金属形态对外售卖的云服务商,这条路走不通。原因有三条:
- 极致性能要求排除 overlay 封装。为了给用户提供裸金属级别的吞吐,云服务商不能靠在网卡侧做 overlay 封装来隔离租户业务地址空间与云服务商地址空间,而要把租户业务 IP 直接暴露在网络集群里。业务地址一旦直接暴露,就不存在”用云服务商地址段做汇聚”的空间。
- 动态迁移排除固定网段。同一租户的 GPU 服务器今天接在 TOR-1 下,明天可能因为运维或调度原因迁到别的 TOR 下,而租户要求迁移前后 IP 不变。为每台 TOR 分配固定 IP 网段的策略因此无法实施。
- 多上连接入要求明细路由上行。为提升稳定性与接入规模,网卡双上连、4 上连已被普遍采用。同一张网卡的明细路由可能同时挂在多台 TOR 下,failover 时需要基于明细路由把流量绕到其它 TOR。这就要求明细路由必须从 TOR 层向上发布,而不是被汇聚掉。
三条约束叠加的结论是:明细业务路由既要保留,又要在全集群范围内可达。汇聚这条捷径被封死了。
3. 问题拆解:TOR 为什么必须从每台 Spine 学全量
3.1. 两个耦合在一起的原因
把现象归因到机制,33M 这个数字来自两个原因的乘积:
- BGP 路由的逐跳传递。业务路由从源 TOR 出发,经 Spine 中转,再到达目的 TOR。Spine 不做汇聚,就必须原样转发全量明细。
- 对 256 台 Spine 的完整可达性。2 层 CLOS 里,TOR 与每台 Spine 都有等价路径。要让流量能走任意一台 Spine,TOR 就得从每一台 Spine 都学到同一批前缀。
第一个原因贡献了 131K 这个乘数,第二个原因贡献了 256 这个乘数。
3.2. 一个关键观察:两类路由的规模差 170 倍
回看 1.2 节的表:infra 路由只有 768 条,业务路由有 131K 条,两者相差约 170 倍。
而这两类路由的 变更频率 同样相差悬殊。infra 路由对应设备自身的 loopback 地址,只在设备上下线、链路故障时变化;业务路由对应租户网卡地址,随租户扩容、缩容、迁移持续变化。
规模差 170 倍、变更频率也差一个量级的两类路由,却在同一条 BGP 通道里被逐跳传递。 这是我认为整份材料里最值得注意的一点,它直接指出了问题的结构性来源。
3.3. 业界的三条路
同一场演讲把业界的已有思路摆在一起做了对照:
- 由 controller 下发业务路由(演讲中标注为 Google’s suggestion)。Spine 层只用 BGP 学 infra 路由,业务路由由集中式控制器推送。每台 TOR 的 BGP 条目降到 (m+n) × m = 768 × 256 = 196K。
- 由 RR 下发业务路由(演讲中标注为 Cisco’s suggestion)。BGP 条目同样是 196K,区别在于业务路由走 BGP Route Reflector[^4],而不是私有 controller 协议。
- 改用 SRv6 承载可达性。Microsoft 在 OCP 2025 的 SRv6 for AI Backend 演讲中提出了另一条路线,目标是支撑跨地域规模的 GPU 集群[^5]。我的理解是,这条路线的着眼点是把可达性编码进 locator,从而绕开逐条明细路由的分发压力。此处仅基于公开演讲标题与摘要,不代表 Microsoft 官方结论。
前两条路有一个共同点:都承认 infra 路由与业务路由应该分开传。分歧只在业务路由由谁传、用什么协议传。HPN Pivot 属于第二条,用 BGP RR 承接业务路由。
HPN Pivot选择RR路线的原因在于,RR 走的是标准 BGP 协议,TOR 侧不需要引入新的协议栈,交换机操作系统也不用大改。对一个已经把 BGP 当作默认控制面的团队来说,这个选择把改造面收到了最小。
4. 方案:把 infra 路由和业务路由拆成两条通道
4.1. 整体结构
HPN Pivot 的做法可以概括为四条:
- TOR向Spine同时传递业务路由与infra路由,但Spine只向TOR传递infra路由。
- 部署独立的 RSC-BGP 实体承担 BGP RR 角色,与 TOR 之间建立多跳 BGP Peer,负责业务路由在 TOR 之间的传递。
- TOR 与 RSC-BGP 之间传递业务路由时,保持业务路由的下一跳为 TOR 自身的 infra 地址不变。
- TOR 转发业务流量时,通过路由的迭代查找特性,最终基于 infra 路由解析出对应的上连 Spine 出接口。
OCP session上,把这套机制归纳为三个名字:Loopback-Based Next Hop、Centralized Route Aggregation、Two-Level Recursive Forwarding。
[图 1:HPN Pivot 两层网络结构示意。上半部为 Spine 层与 TOR 层之间的 infra 路由 BGP 通道;右侧为 RSC-BGP 组(4 实例)与全部 TOR 之间的多跳 eBGP 业务路由通道;下方为 GPU 服务器的 /32、/64 明细路由。管控面由 Pivot-Manager 与 ENC 通过控制通道纳管。]
4.2. Spine 层只中转 infra 路由
第一条是整套方案的地基。Spine 不再中转业务路由,只中转 infra 路由。
按 1.2 节口径,单台 TOR 从 Spine 侧学到的 BGP 条目因此变成:
(m + n) × m = 768 × 256 = 196K从 33M 到 196K,下降约 170 倍,也就是两个数量级以上。
这里要说明一点:196K 并不意味着路由条数变少了。集群里的业务路由仍然是 131K 条,一条没少。变化在于 这 131K 条不再从 256 个方向各来一份,而只需要从 4个 RR 实例各来一份。
4.3. RSC-BGP:集中承接业务路由
RSC-BGP 是承载 RR 角色的 BGP 实体名称。它与 TOR 之间建立多跳 eBGP,负责把某台 TOR 通告的业务明细路由分发给同集群内的其它 TOR。
组织方式上,RSC-BGP 以 4 个实例为一组,以避免单个实例异常带来的稳定性风险。
按公开口径,学全量业务路由的 BGP Peer 数量从 256 降到 4。Peer 数量的下降比 RIB 条目数的下降更直接影响 BGP 进程的行为。最优路径计算的比较对象、UPDATE 消息的来源数、会话维护开销,都随 Peer 数线性变化。
4.4. 下一跳保持为 TOR 自身的 infra 地址
第三条机制很容易被略过,但它是整套设计能成立的关键。
TOR 向 RSC-BGP 通告业务路由时,把下一跳改成自己的 infra 地址(loopback)。RSC-BGP 通过多跳 eBGP 分发业务路由,并配置 保留原始 NEXT_HOP,使其继续指向业务接入 ToR 的基础设施地址
保留原始下一跳的直接后果是职责分离。RSC-BGP 只负责回答”这条路由存在,它属于哪台 TOR”,不负责回答”怎么到那台 TOR”。后者由 infra 路由回答,两类信息在 TOR 本地拼装。
4.5. 两级递归转发
第四条机制是转发面的落地方式。TOR 收到一条业务路由后,做两级解析:
- 第一级:业务路由 → 下一跳为源 TOR 的 infra 地址。
- 第二级:infra 地址 → 由从 Spine 学到的 infra 路由解析出真实出接口,指向某台 Spine。
这正是 RFC 4271 描述的下一跳解析行为。本地 BGP Speaker 要先把 NEXT_HOP 解析到一条可直达的路由上,才能得到出接口。Pivot 没有发明新的转发机制,只是把这种递归解析用到了极致。
[图 2:两级递归解析示意。左侧为 131K 条业务路由,全部指向数量级为百的 TOR infra 地址集合;右侧为 768 条 infra 路由,指向 256 台 Spine 出接口。故障发生时只有右侧需要更新。]
5. 关键实现
方案的四条机制在协议层面都不复杂。真正决定它能不能落地的,是承载 RR 的实体形态、可靠性设计,以及 RR 全失联时的兜底。
5.1. RR 载体:为什么是容器,不是物理路由器
演讲用了整整一页讲三个部署决策。
5.1.1 形态:物理设备 vs 虚拟化 RR。结论是虚拟化 RR。传统做法是采购独立的高性能路由器充当 RR。代价是物理位置规划、设备采购成本,以及以月计的交付周期。
改成运行 AliNOS 镜像的容器实例后,RR 的部署变成管控自动化流程里的一步。时间尺度从月降到分钟。容器实例还能在物理服务器之间快速迁移,用于灾备恢复。它同时能用上服务器级 x86 CPU 的性能和足够大的内存空间。这恰好是大规模 BGP RIB 最需要的两类资源。
5.1.2 位置:中心化云端 vs 集群同址。结论是集群同址。这一点值得多说一句:既然 RR 已经是容器,把它集中放在某个中心资源池里,运维上会省事得多。该团队没有这么做,理由是保证低时延和高可靠的 BFD 会话。BFD 对时延与抖动敏感,而 RR 与 TOR 之间的多跳 eBGP 会话要靠 BFD 做快速故障检测。把 RR 拉远,等于把检测可靠性交给了一段不受控的路径。
5.1.3 运维:手工 vs 自动化生命周期管理。结论是引入 Pivot-Manager,负责 RR 的供给、扩缩容与生命周期管理。另有 ENC 承担 TOR 与 RSC-BGP 之间动态 BGP 配置的下发。
页面上还有一条注记:No K8S。这是一个明确的技术选型表态——RR 容器不由 Kubernetes 编排。网络设备侧的容器对启动顺序、网络命名空间都有较强约束。它们还要与交换机控制面耦合。直接由专用管控平台管理,比套一层通用编排系统更可控,也更轻量。
5.2. 可靠性:4 实例一组,跨机架跨网络集群
演讲给出的底线是原文一句话:any RR outage should not impact AI cluster。围绕这条底线的设计有四点:
- 4 个实例靠近 AI 网络集群部署。
- 4 个实例分布在不同物理服务器上。
- 这些物理服务器位于不同机架,并通过两套不同的网络集群接入。
- 每个 RR 实例独立与该集群内全部 TOR 建立会话,4 个实例分发相同的路由。
第 4 点是最重要的一条。它意味着 4 个实例之间 不做任何状态同步,而是各自独立地从 TOR 学习、再各自反射给 TOR。这样做的代价是同一批路由被分发 4 次,TOR 侧要为每条业务路由维护 4 份 path。收益是不存在实例间的一致性问题:任意实例失效都不需要选举,也不需要状态迁移。
这里还有一个附带好处:4 份 path 的下一跳都指向同一台源 TOR 的 infra 地址。因此任意一个 RR 实例失效,都不会改变 FIB 里的转发结果。
5.3. BGP Group GR:让 RR 全失联变成非事件
多实例设计已经把单点故障的概率压得很低。但极端场景仍然存在:与某台 TOR 建 Peer 的 4 个 RR 实例同时异常。
标准 BGP Graceful Restart(GR,RFC 4724)是 per-peer 机制。会话断开后,本地保留从该 Peer 学到的路由,在 Restart Time 内等待对方恢复。超过 Stalepath Time 仍未恢复,则清除这些路由。
把 per-peer GR 直接用在 4 个 RR 实例上会有问题。任意一个实例重启都会触发一次 GR,而剩下 3 个实例仍在正常更新路由。此时进入保留状态,反而制造了不必要的路由冻结。
HPN Pivot的做法是引入 BGP Group GR,规则只有两条:
- 只有组内 最后一个 Peer 断开才触发 GR。
- 组内 第一个 恢复的 Peer(重连或新建)复位处于激活状态的 GR。
演讲给这个机制的定位是 headless forwarding——控制面无头状态下仍能转发。效果是:4 个实例全部异常时,TOR 侧已有的业务路由表项保持不变。任一实例恢复后,再按新的更新处理。
这条设计换来一个很实用的性质。即使RR 全失联的,已经在线运行的存量业务不受影响。
6. 效果
6.1. 计算口径
本节所有数字来自H OCP上HPN Pivot 演讲材料的设定,是按架构口径推算的值。它们不是某个生产集群的实测统计。
| 口径项 | 取值 |
|---|---|
| 组网形态 | 2 层 CLOS,收敛比 1:1 |
| 交换芯片 radix | 512 |
| Spine 数量 m | 256 |
| TOR 数量 n | 512 |
| 每 TOR 下联网卡数 | 256 |
| 每网卡 IP 数 | 1(IPv4 /32 或 IPv6 /64) |
| 集群业务路由总量 | 131K |
| 集群 infra 路由总量 | 768 |
| RR 组实例数 | 4 |
| 对比基线 | 传统 BGP:业务路由经 Spine 逐跳全量传递 |
6.2. 对比
| 指标(单台 TOR) | 基线:传统逐跳 BGP | HPN Pivot | 变化 |
|---|---|---|---|
| 从 Spine 学到的 BGP 条目 | 131K × 256 = 33M | 768 × 256 = 196K | 下降约 170 倍 |
| 学全量业务路由的 BGP Peer 数 | 200 以上(Spine 数量级) | 4(单组 RR 实例数) | 下降 50 倍以上 |
| 从 Spine 学到的业务路由 | 131K 条 × 256 份 | 0 条 | 完全解耦 |
| 集群业务路由总量 | 131K | 131K | 不变 |
| 端到端转发路径 | TOR→Spine→TOR | TOR→Spine→TOR | 不变 |
| 隔离再入网需重学的 path | 约 33M | 约 196K + 131K x4 ≈ 720K | 下降约 50 倍 |
6.3. 改善了什么
收敛行为的改善来自结构,不是来自优化。 这是我认为整套设计最漂亮的地方,值得单独算一次。
按公开口径推算一次单台 TOR 失效。传统方案下,256 台 Spine 各自要撤销该 TOR 的 256 条业务路由,其它每台 TOR 需处理约 256 × 256 = 65K 条 UPDATE。Pivot 方案下,同一事件只需撤销 1 条 infra 路由,其它每台 TOR 处理约 256 条 UPDATE。受影响的那 256 条业务路由,在本地重新做第二级递归解析即可。
BGP 控制面需要处理的更新量,从 6.5 万级降到百级。 而数量最大的 131K 条业务路由,其下一跳在整个过程中保持不变。这正是两级递归带来的收益:故障被吸收在 infra 路由层。
7. 技术边界与后续方向
7.1. 依赖条件
Pivot 不是一个可以单独开关的特性,它把一部分网络可用性押在了几项前置条件上:
- 管控平台必须可靠。RR 的供给、扩缩容、配置下发、生命周期管理全部依赖 Pivot-Manager 与 ENC。管控异常会影响 RR 的扩容与变更;虽然不影响存量转发,但会削薄冗余度。
- 容器与宿主机的可靠性进入了控制面故障域。物理路由器时代的 RR 故障域是设备级的;容器化之后,宿主机操作系统、容器运行时、镜像版本都在这个故障域内。跨机架、跨网络集群的分布设计正是对此的补偿。
- infra 路由层必须保持标准 BGP 行为。两级递归的正确性完全建立在 infra 路由的可达性之上。
7.2. 后续:把 Group GR 推到开源社区
演讲的 Call to Action 有两条:继续随 AI 集群规模增长增强 BGP 的规模与性能;推进 BGP Group GR 的增强。
这一点比方案本身更值得注意。BGP Group GR 解决的是”一组等价 RR 实例整体失效”这个通用问题,不是阿里云独有的场景。任何用多实例 RR 承接大规模路由分发的网络都会遇到它。把它作为开源增强推进,意味着这个机制有机会变成 SONiC 生态的公共能力。
从更大的视角看,业界在同一个问题上给出了至少三种答案。一是用 SRv6 承载可达性,二是由 controller 下发业务路由,三是由 RR 下发业务路由。
HPN Pivot 选了第三条。理由是改造面最小,且与既有 BGP 语义兼容。这不构成对其它路线的否定——不同团队的控制面基础、产品形态与运维约束不同,最优解也不同。