别急着把光引擎焊死:云栖上的 IPO 交换机、6.4T UPO,和刚发布的 OpenCPX
从电通道、可维护性与连接器可靠性出发,解析云栖 IPO 交换机、6.4T UPO 与 OpenCPX 的架构思路和工程取舍。
1. 先辩一辩:CPO 真的是终局吗
这两年你只要参加任何一个互连技术的会,总能听到一种论调: CPO(Co-Packaged Optics)是终局,其它一切都是过渡。说这话的人通常还会补一句:物理距离决定损耗,光引擎离 die 越近越好,所以合封是必然。
我不同意。准确地说,我不同意的是这个推理里偷偷塞进去的那个假设—— “电通道要短”和”光引擎要和 ASIC 绑死”是两件事,前者是物理,后者是工程选择,你把工程选择说成物理必然,这就有问题了。
先问一个问题:光引擎和交换芯片焊死在一起,坏了怎么办?
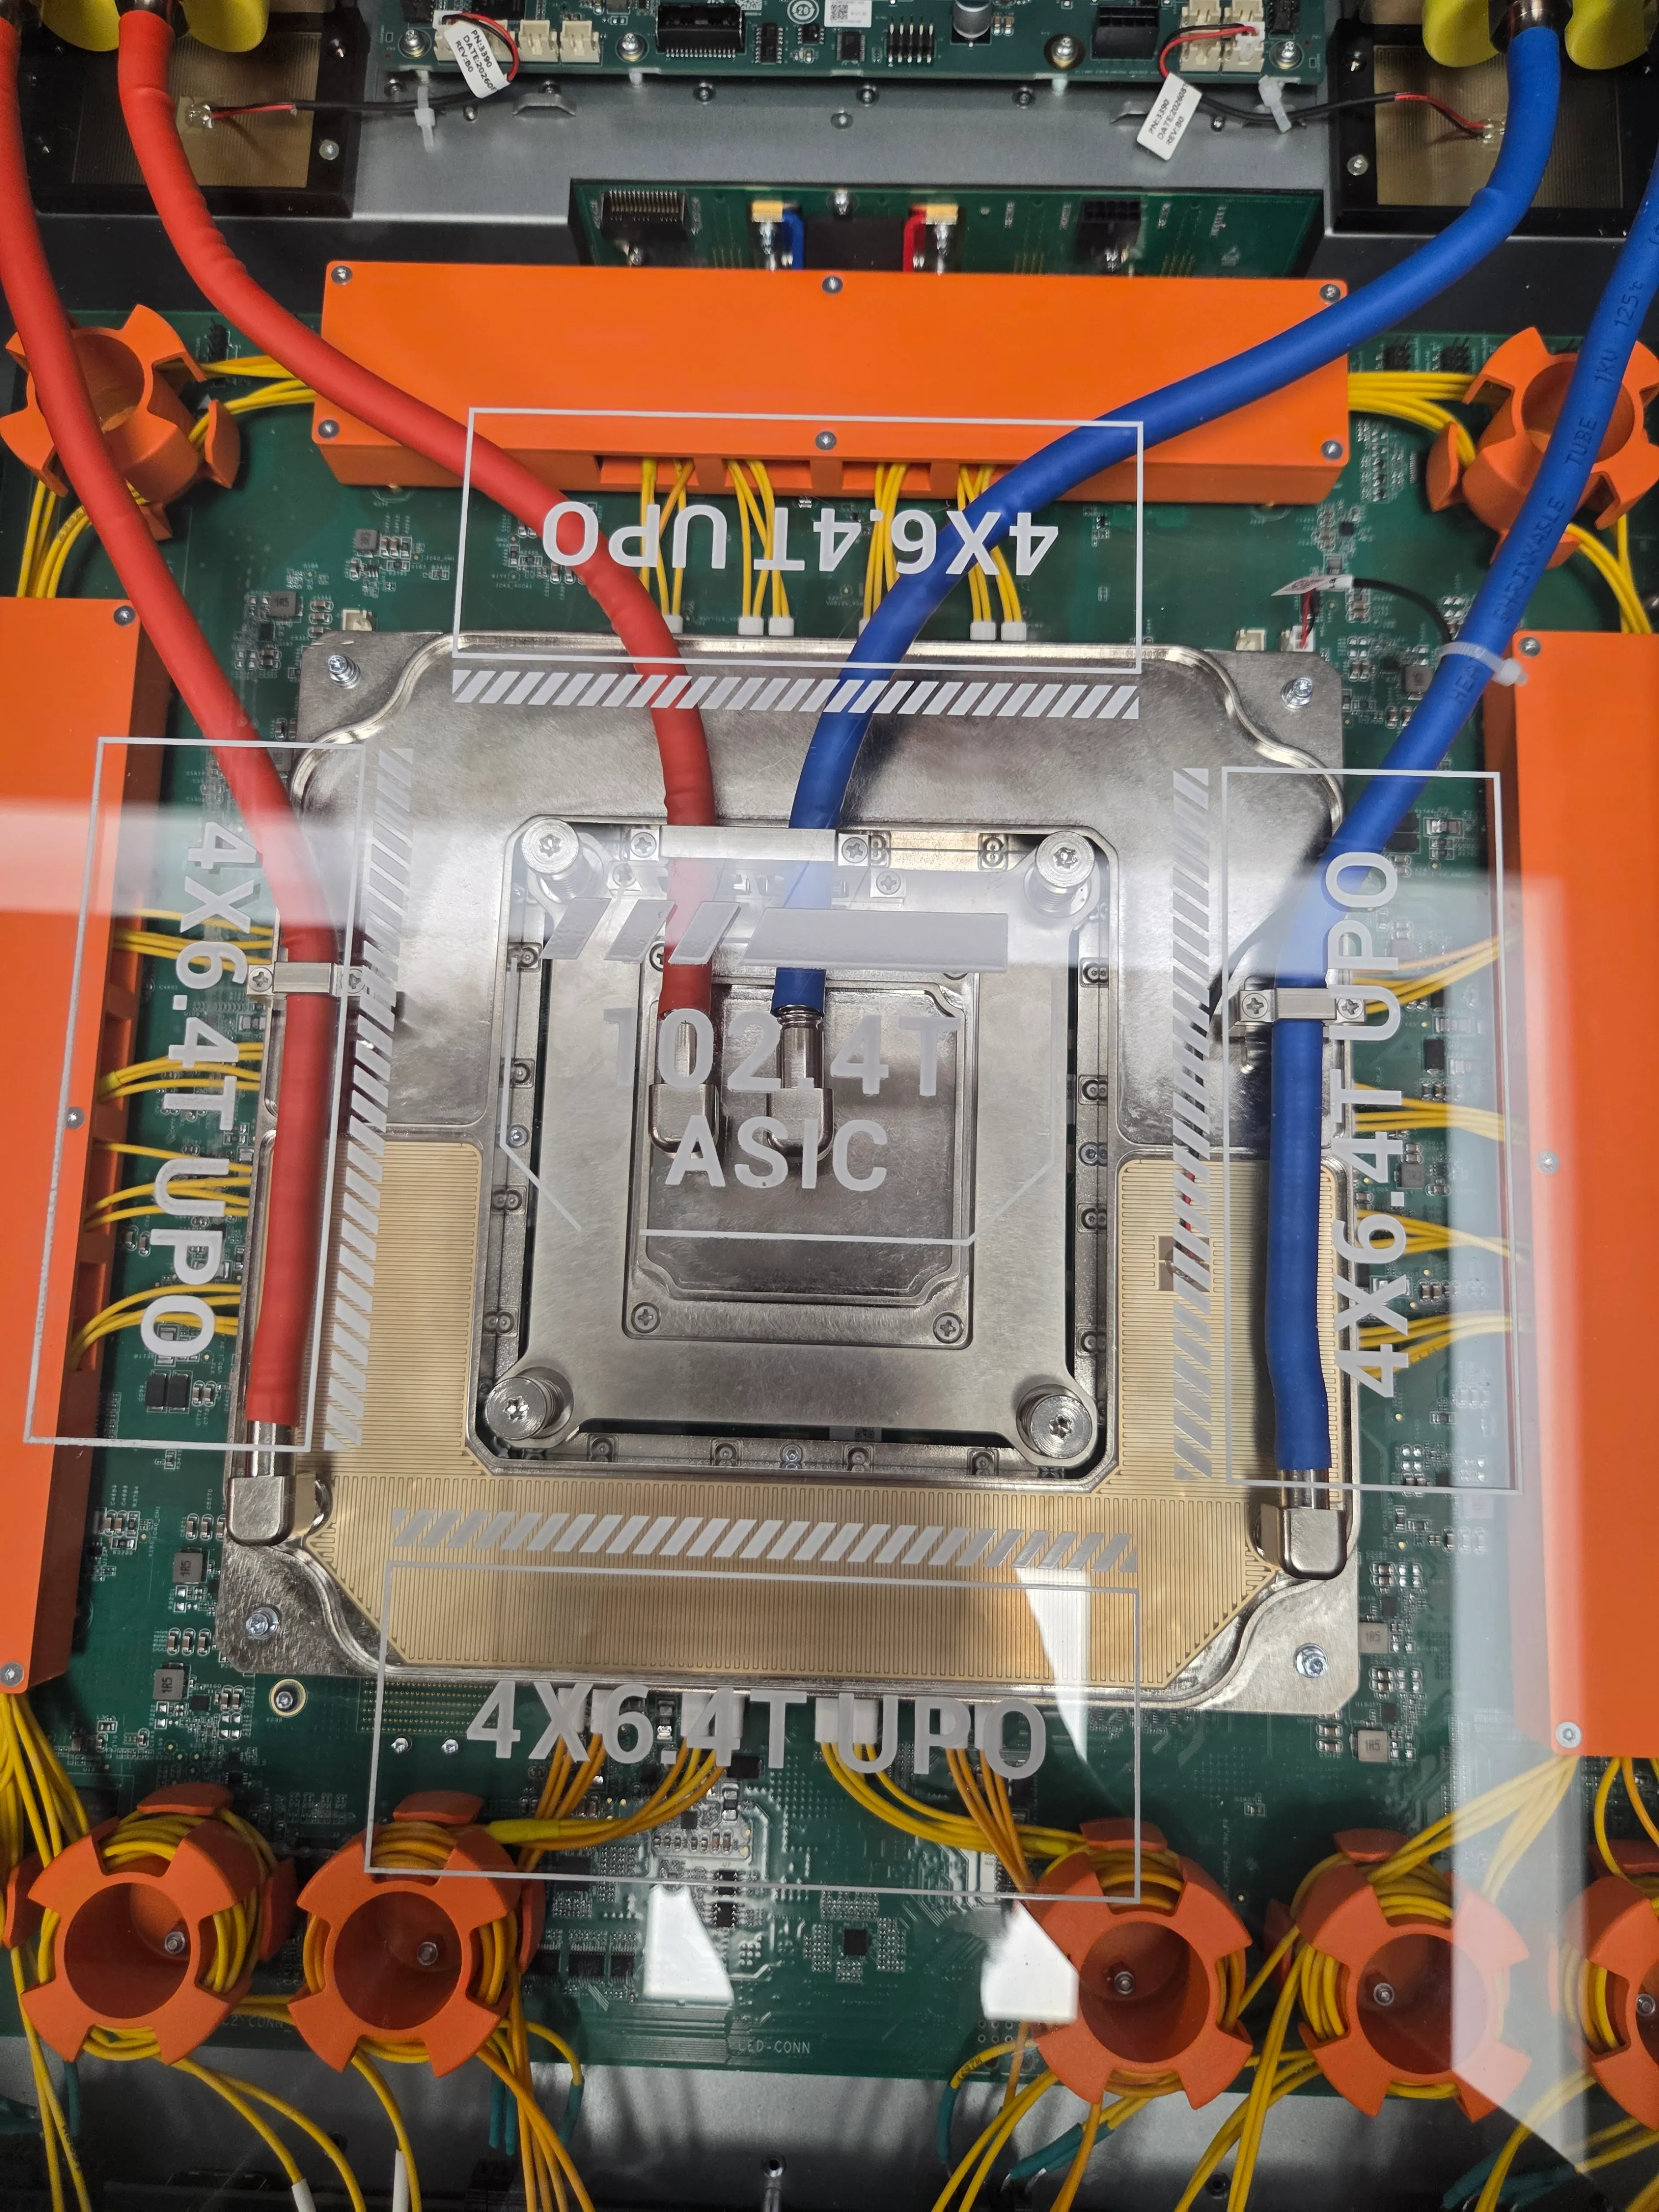
这不是抬杠。前几天云栖大会现场,阿里云展出了一台 102.4T 的 UPO 交换机。这台机器最特殊的不是容量数字,而是光引擎和交换 ASIC 之间的连接形态:不是前面板可插拔,不是 PCB 上的 NPO,也不是合封的 CPO,而是一种叫 IPO(InterPoser Optics,不是股票那个 IPO) 的中间形态——高速信号从芯片封装基板上层直接出到一个高密 interposer 连接器,光电器件部署在 interposer 上, 光引擎和 ASIC 之间是可拆的。
几乎同一周,大洋彼岸的 Open CPX MSA 发布了 CPO 解耦标准规范 OpenCPX Specification v1.0,里面 Type-1 架构的设计思路和 IPO 高度重合。一边是标准文档刚刚落地,一边是实物已经摆在展台上通电演示——这两件事撞在同一个星期里,不是巧合,是行业对同一个问题的回答开始收敛了。
这篇文章想说清楚三件事:
- 电通道这笔账到底该怎么算,为什么”跳过 BGA”比”贴着 die”更重要;
- 阿里云网络团队搞的 IPO 这个形态新在哪,难在哪,以及它凭什么不是 PPT;
- UPO、OpenCPX 这两个标准放在一起看,说明了什么。
2. 电通道这笔账:224G 到底难在哪
要看懂 IPO,得先把主芯片到光引擎之间那段高速电通道的账算清楚。
传统可插拔方案里,高速信号从交换 ASIC 的 die 出发,要走完这么一条路:
die → 封装基板(substrate) → BGA 球阵 → 主板 PCB 走线 → 板级连接器 → 模块侧接口 → 模块内部 PCB → 光电芯片这条路在 112G/lane 时代还能靠优化勉强做出来;到 224G/lane,难度不是线性上升,是台阶式上升。原因不神秘,回到物理:
第一,损耗随频率恶化。 导体损耗随频率按 √f 增长(趋肤效应),介质损耗随 f 线性增长。224G/lane 是 112GBaud PAM4,Nyquist 频率 56GHz——同一块板子、同一段走线,在这个频点的插损比你熟悉的 28GHz 高出一大截。
第二,PAM4 把裕量又砍了一刀。 同样的总摆幅下,单个眼的垂直裕量被压缩到约 1/3,因此 PAM4 对噪声、抖动、线性度和通道损耗明显更加敏感。
第三,每个过渡点都是阻抗不连续。 via、连接器、BGA 球、金手指,每一个都是反射源。速率低了反射可以被均衡器吃掉,速率高了这些反射会叠加、谐振,均衡器的抽头数和功耗跟着涨。
把这三条合起来,结论就是: 224G 时代,电通道预算里最贵的不是”长度”这个笼统概念,而是”过渡点数量 × 每个过渡点的反射与损耗”。铜缆为什么在 224G 时代有效距离被压到 1 米量级?同样的账。
这时候你就能理解,为什么整个行业都在往”光引擎离芯片更近”的方向挤——本质上大家都是在给这段电通道做减法。但做减法有两种思路:
- 思路 A:把光引擎一路搬到 die 旁边,然后焊死。 这是 CPO。电通道最短,性能上限最高,代价是光电深度耦合,下面第三节细说。
- 思路 B:把电通道里最烂的几段直接跳过,但保留可拆的机械界面。 这是 IPO / OpenCPX Type-1 这一族。
思路 B 听起来像是折中主义,但你把账算细一点就会发现,它砍掉的恰恰是账本上最贵的那几项。
3. 四种形态,两个维度
这两年冒出来的高密光引擎形态不少:FRO/LPO(可插拔)、NPO(近封装)、IPO(interposer)、CPO(共封装),还有 Arista 牵头的 XPO 这种把可插拔做到 12.8T 的激进封装。名字看花了眼,但抓住两个维度就都清楚了: 光引擎离主芯片有多近(性能维度),以及光引擎和主芯片能不能拆开(运维与生态维度)。
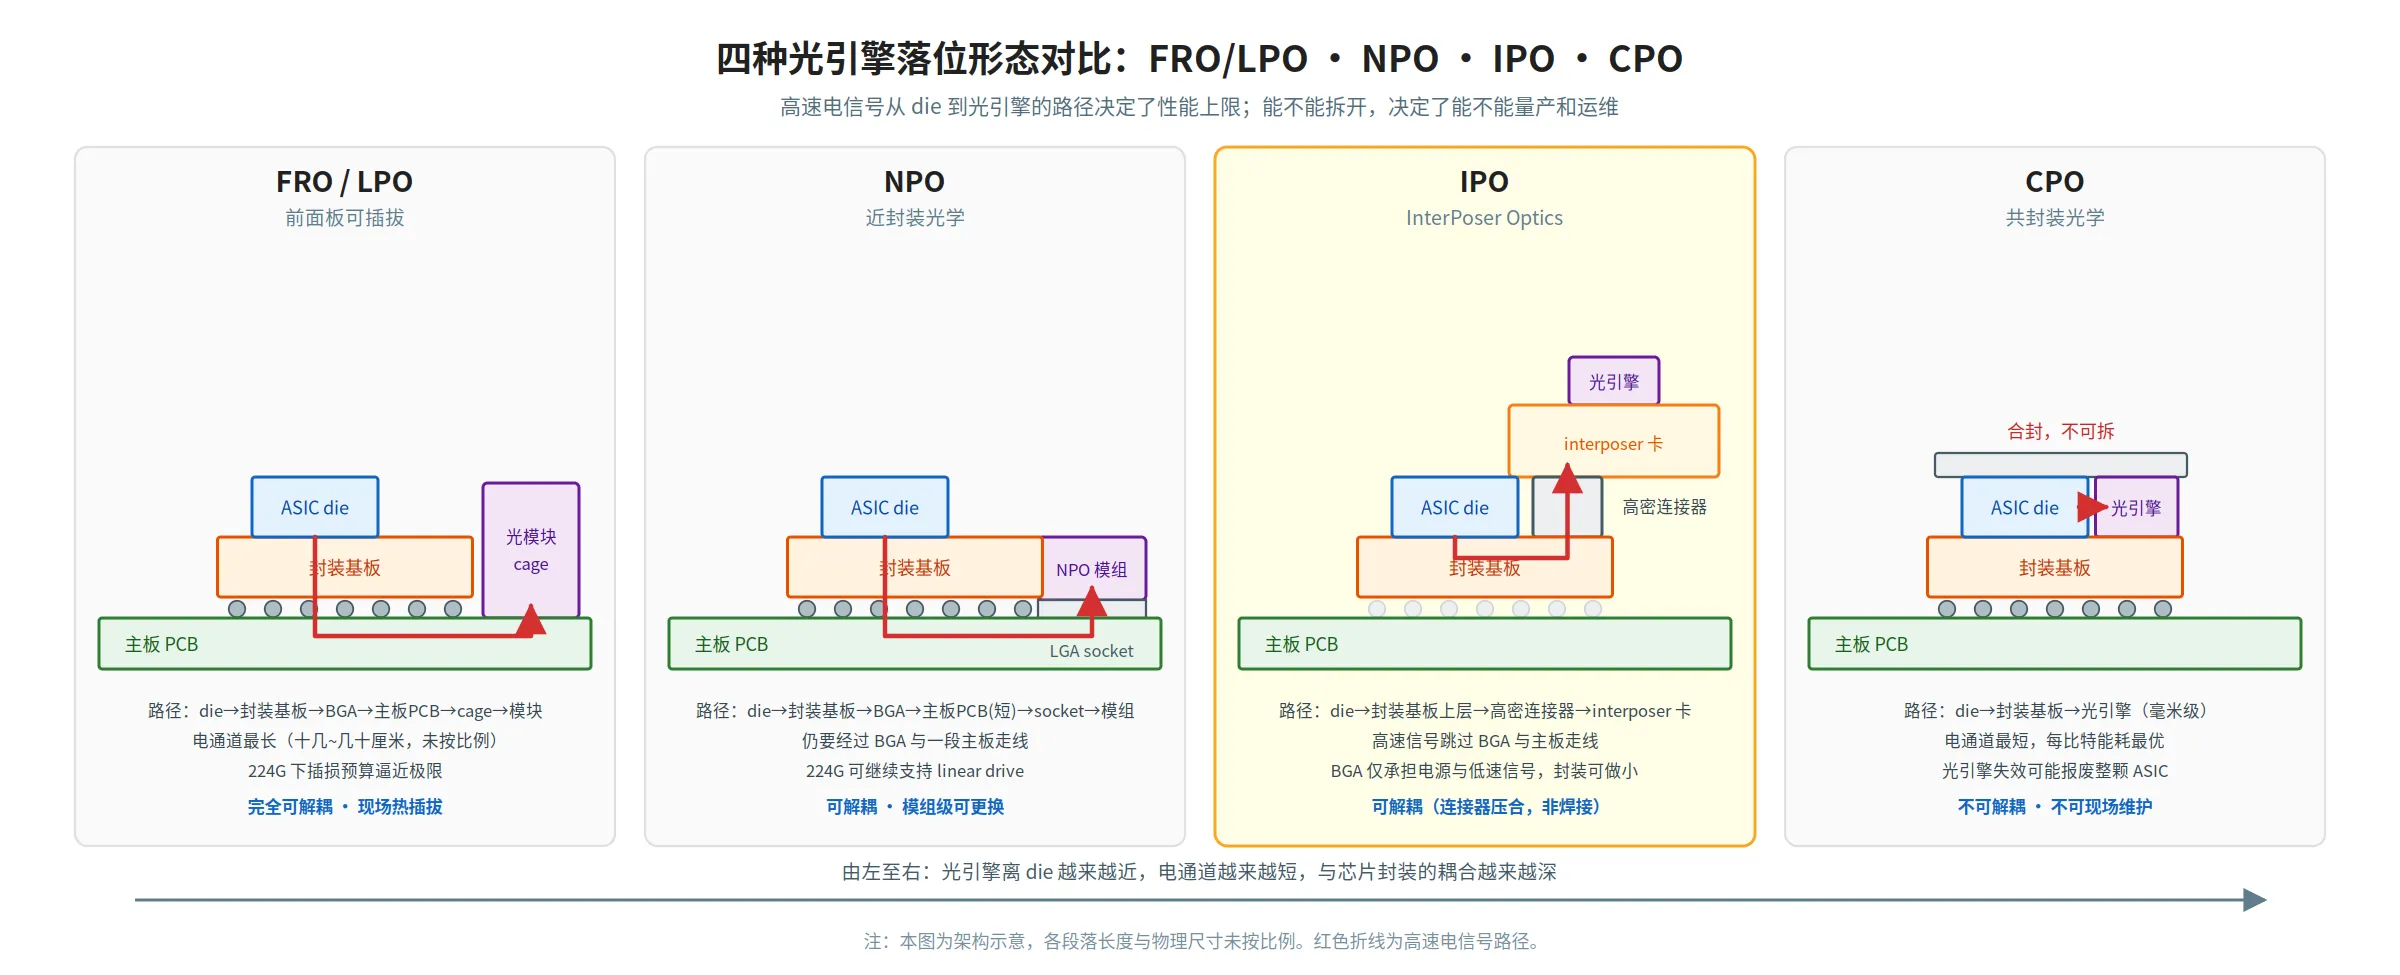
沿着性能维度从远到近排: FRO/XPO > NPO > IPO > CPO。越近,电通道越短、损耗越小、越容易做 linear drive(去掉 DSP 的线性直驱)、能效越好。
沿着可拆维度排,顺序正好反过来:可插拔现场热插拔;NPO 通过 LGA socket 可拆卸,坏了返厂换模组;IPO 的 interposer 与主芯片不绑死;CPO 合封之后, 不可拆(感谢OpenCPX拯救了大家😄)。
大多数讨论只沿着第一个维度展开,然后得出”CPO 最优”。这是错的,因为你漏算了第二个维度上的账,而那个账在大规模运维里比插损更贵。
3.1. blast radius 才是运维的第一性原理
数据中心运维真正关心的,从来不只是一个器件的 FIT 或平均故障率,而是:这个东西一旦坏了,我到底要换多大的东西。
前面板可插拔模块最简单。一个模块坏了,拔下来换一个,故障域就是一个端口。
NPO 往里走了一步。光引擎离 ASIC 更近,维护动作变复杂了,很多时候需要停机甚至返厂,但至少 optical engine 和主芯片还是两个独立器件。
真正需要警惕的是永久集成型 CPO。
如果 optical engine 被永久键合在 ASIC package 上,那么 PIC、EIC、fiber attach 或其它封装内器件出现不可修复故障之后,维修单位就有可能从“一个光模块”扩大成“一整个 package”,极端情况下甚至是整块交换板。
这才是 CPO 真正需要算的 blast radius。
注意,我这里说的是“永久集成型 CPO”,不是说所有 CPO 都一定如此。
事实上,行业自己已经在主动拆这个故障域:laser 可以通过 ELS/ELSFP 放到封装外面;optical engine 可以通过 socket 做成可拆;fiber attach 也可以继续模块化。OpenCPX Type-1 做的,本质上就是其中一步——仍然把高速接口做到 package substrate,但不再要求 optical engine 和 ASIC 永久绑定。
3.2. 良率是会相乘的
制造端还有另外一笔账:越多高价值器件在最后阶段永久集成,late-stage scrap 的代价就越高。
ASIC、PIC、EIC、封装、光纤耦合,每一层都有自己的良率。如果没有足够充分的 Known Good Die、Known Good Optical Engine 和封装前测试,那么任何一个环节出问题,都可能把前面已经通过测试的昂贵器件一起带走。
从数学上说,多个独立工艺环节的良率确实存在复合效应。
但真实量产当然不会简单到“两个 95% 良率的器件直接封起来,所以最后就是 90%”。
真正的工程问题是:你能在多早的时候把坏件筛出去,以及最后一次不可逆集成发生在什么位置。
这也是解耦架构有吸引力的原因。
如果 optical engine 可以在装到系统之前完成独立测试、老化和筛选,ASIC 也可以作为独立 KGD 测试,那么最后装配阶段即使仍然有损耗,也不会轻易把一个本来合格、而且非常昂贵的 ASIC 一起拖进 scrap bin。
换句话说,CPO 不是没有办法解决良率,而是越深度集成,对测试覆盖率、KGD/KGOE 能力和最终装配良率的要求越苛刻。
这笔钱最终都会体现在系统成本里。
(顺便说,CPO 阵营自己也知道这个问题,所以 Samtec 在 OCP 2025 上展示过 socket 化的 CPX 方案,现在 OpenCPX 把它做成了标准——这其实等于承认了”可拆”是绕不过去的需求。)
4. IPO:它跳过的不只是 PCB,是 BGA
现在可以说回云栖那台机器了。
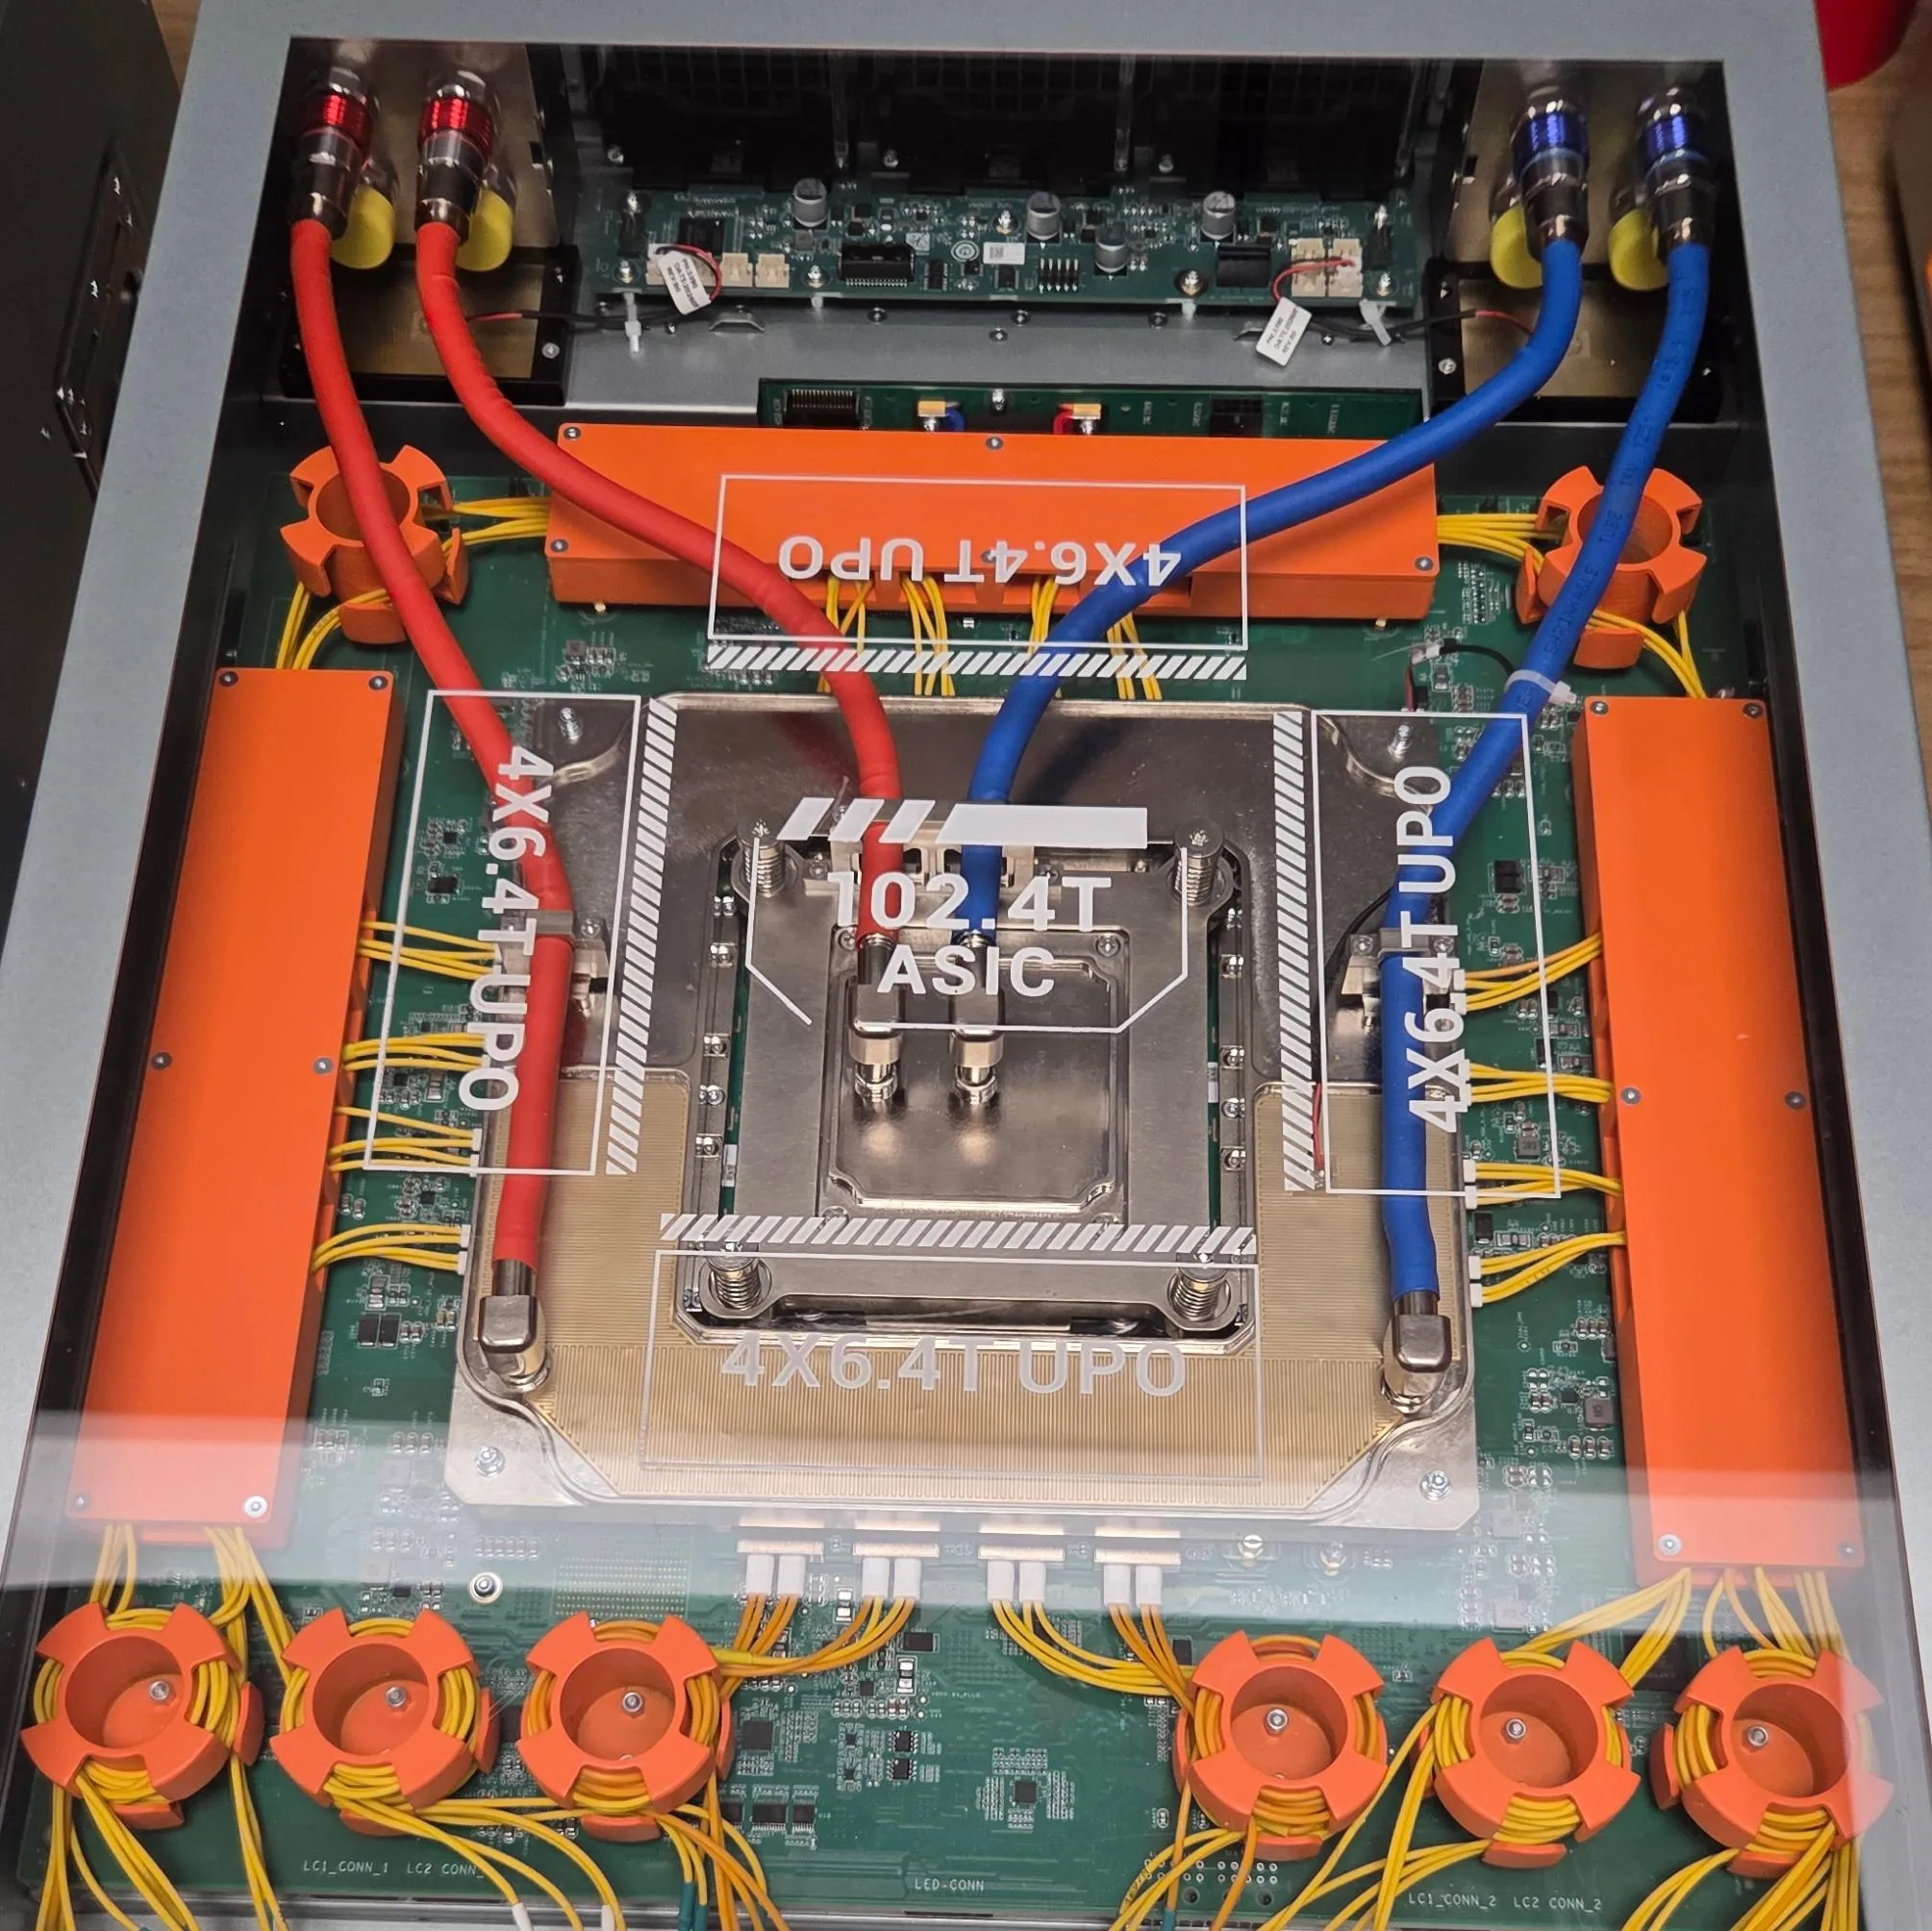
IPO 的核心思路,是在主芯片 die 附近引入一个高密度 interposer 连接器,光电器件部署在 interposer 上。它和 NPO 的区别不是”摆得更近一点”这种量变,而是电通道结构上的质变。
4.1. 它绕开的不只是 PCB,是 BGA
NPO 的路径是:die → 封装基板 → BGA → 主板 PCB(短)→ LGA socket → 模组。信号还是要从 BGA 出来。
IPO 的路径是:die → 封装基板上层 → 高密 interposer 连接器 → interposer 上的光电器件。 BGA 这一段被整个跳过了。
这带来两个收益,第二个比第一个重要:
第一,少了一个过渡点,少了一段高损耗路径。 BGA 球阵是典型的阻抗不连续结构(球形触点的电感和电容在 50GHz 以上会形成明显反射),封装基板那段又是单位损耗最高的。跳过它们,通道裕量直接改善。
第二,主芯片封装可以做小。 这才是关键。高速 I/O 不再需要从 BGA 逃逸,BGA 就只承担电源和低速信号,球数大幅下降,封装基板面积和层数都能压下来。封装小了,基板内走线也短了,损耗进一步下降。
这是一个正反馈,不是一次性的省损耗。 你省下来的不只是几个 dB,是主芯片封装的设计自由度。
做过大芯片封装的都知道,102.4T 级别的交换芯片,封装基板的逃逸布线(escape routing)本身就是设计瓶颈之一:几千个高速球要在基板上找路出来,球数、层数、面积、损耗互相咬。IPO 把这个死结从侧面解开了。
4.2. 真正值得看的,不是“比 CPO 多一个可拆”,而是 package-level I/O 也可以可拆
这里需要把一个概念讲准确。
可拆并不是 IPO 对 CPO 的专属优势,因为 CPO 本身也完全可以做成 socketed。
真正值得看的,是云栖这台机器选择了一种非常明确的工程路径:
高速信号已经不再经过传统主板长距离逃逸,而是直接从 package substrate 这一层出来;但 optical engine 又没有和 ASIC 永久绑定,而是通过高密连接器保持机械解耦。
这样做的结果是:
- optical engine 可以在系统集成之前单独测试和筛选;
- optical engine 出问题时,不一定需要连 ASIC 一起报废;
- ASIC 和 optical engine 可以保持相对独立的迭代节奏;
- 理论上也给多供应商 optical engine 留出了空间。
所以我更愿意把 IPO 看成一种 socketed、package-level optical I/O 实现,而不是非要把它定义成“介于 NPO 和 CPO 之间的第四种物种”。
从这个角度看,它和 OpenCPX Type-1 的亲缘关系反而更清楚:
大家都接受一个前提——高速 SerDes 应该尽量在 package 这一层完成 escape;真正还在争论的,是这个接口之后到底应该永久集成,还是继续保留可维护边界。
4.3. 同一个 package-level I/O 思路,也能出铜
当高速 I/O 已经能够从 package substrate 的 top-side 直接引出来之后,后面接的并不一定非得是光。
接 optical engine,可以做成这篇文章讨论的 IPO / socketed optical engine;接高速铜缆,则可以形成 CPC(Co-Packaged Copper)或者类似的 top-side copper attach 架构。
它们真正共用的,是前半段:
die → package substrate → top-side high-speed interface
到这里为止,高速信号不再需要先穿过传统 BGA,再在主板上跑一段长 PCB。
现场同时展出的铜缆直连机器,更值得关注的地方也正在这里:这套 package-level high-speed I/O 平台并不天然绑定光。
光和铜真正的分界,还是 reach。
短距离、柜内、超节点内部,铜的成本和功耗依然极具吸引力;距离一旦继续拉长,插损预算会迅速把系统推向光。
所以更准确的图景不是“光替代铜”,而是:
近距离尽可能用铜,距离上去之后切光,而两者未来可能共享越来越多 package-level I/O 技术。
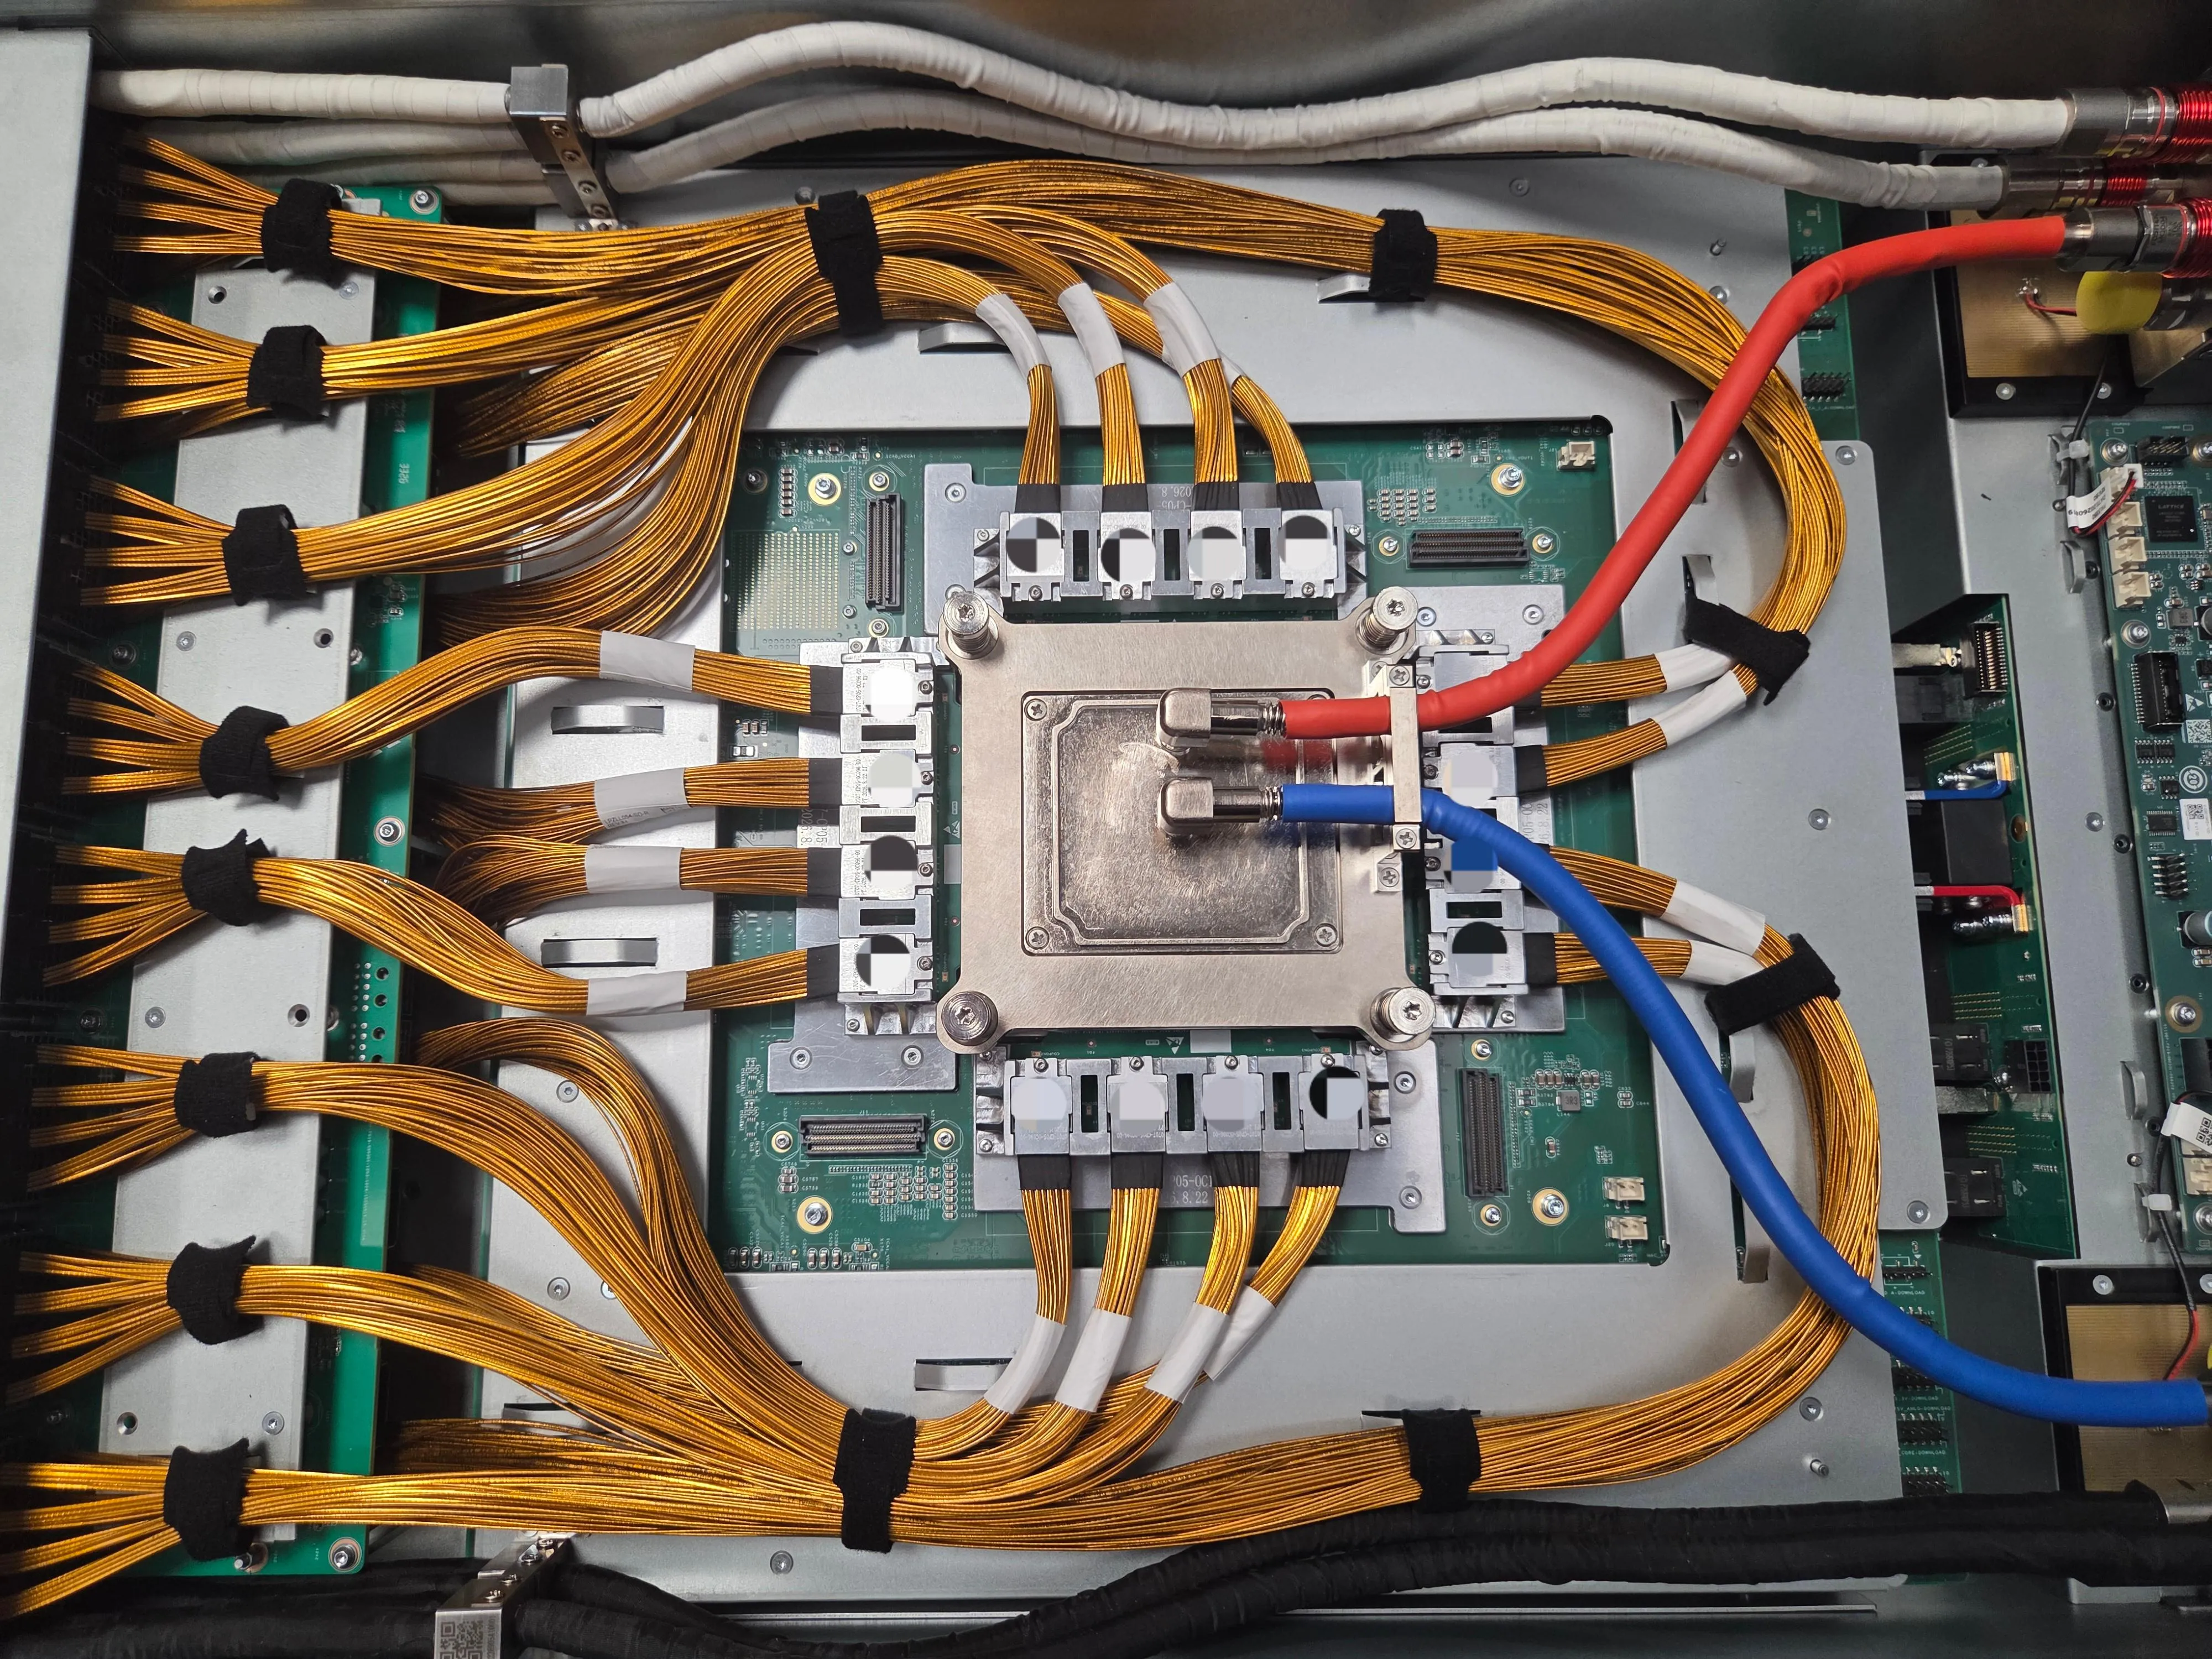
真正的图景不是光替代铜,而是按 reach 分层:柜内铜,跨柜光,底下共用同一个 interposer 平台。 这个平台的价值恰恰在于它不押注介质。
4.4. 难点全在连接器上
讲完好处,讲代价。IPO 最大的难点,目前看就在高密连接器的可靠性上。
一旦速率到 224G、密度到几百个触点,连接器就不再是”普通结构件”,而变成了整个系统的关键高速器件。
这句话需要展开,因为它涉及五个互相耦合的物理问题:
接触稳定性。 接触电阻本身不大(几十 mΩ 量级),但接触界面的电感和电容在 56GHz 上会形成可观的反射。更麻烦的是它不稳定:压力变化 → 实际接触面积变化 → 阻抗漂移。你的通道仿真做得再漂亮,压力窗口没守住,裕量就是浮动的。
装配公差累积。 一块盖板上压几十个模组,每个模组的厚度公差、PCB 平整度、socket 高度公差会叠加起来。LGA 类 socket 对安装压力是敏感的:压力不够接触不良,压力过大压坏 die 或 socket。这不是”拧紧就行”的活,是要算公差链的。工程上的解法是组合盖板——用弹性垫吸收系统公差,用弹簧螺钉持续施压,用背部结构件互锁防板弯,把平整度压到 0.05mm 量级。
热循环。 芯片、连接器、模组三层材料的 CTE(热膨胀系数)不一样。每一次温度循环,界面都在经历微小的相对位移。数据中心不是恒温实验室,它有冷启动、有负载波动、有风扇调速。
机械应力与微动磨损。 上面那个微小相对位移,会导致接触面的氧化膜被破坏又再生,产生接触电阻噪声——这就是 fretting corrosion。它在振动环境下会显著加速。
长期可靠性。 材料的蠕变会让预紧力随时间衰减。你今天测合格的压力,三年后可能已经掉出窗口了。
UPO 标准里那几条机械设计,本质上都在回答同一个问题: 怎么把一个微米级对位、需要恒定压力的机械界面,做成可批量装配、可现场维护的东西。 具体手段包括:XY 方向增加定位 PIN 保证对位精度;Z 方向用独立压块配合背板,让每个模组独立受压,而不是共用一块大盖板把公差串成一条链;连接器到 PCB 和模组之间无焊接,既减少污染环节也保留了可拆性;光纤侧用 Detachable FAU(可插拔光纤阵列),把最难维护的那一段也变成可换件。
5. OpenCPX:标准刚刚追上这个思路
就在云栖之前几天,Open CPX MSA 发布了 OpenCPX Specification v1.0。这个组织今年 3 月才由 Ciena、Coherent、Marvell、Molex、Samtec、TeraHop 六家发起,半年就把第一版规范交了出来,速度不慢。
规范里最值得看的是 Type-1 架构。我翻了原文,几个关键点:
- Type-1 把高速(RF)socket 和管理供电(MP)socket 拆成两个独立 socket,允许装在不同的平面上——原文给的例子就是 RF socket 焊在 ASIC 的 package substrate 上,MP socket 焊在主板上。高速信号从封装基板层面直接出来,这不就是 IPO 的思路吗?
- OpenCPX 定义 6.4T / 7.2T 两档 connectivity,面向 200G/lane 电接口;
- 同一个 socket 既接光模块也接铜缆——又是”介质无关”。
你看, 独立厂商们用标准语言写出来的东西,和云栖展台上那台实物机器,指向的是同一个架构判断:高速界面从封装基板上层引出、光引擎通过标准化 socket 可拆接入、光和铜共用同一个平台。
这个收敛本身就是信息。它说明”可拆的高性能光互连”不是某一家的私有花活,而是产业链上下游(连接器厂、光模块厂、芯片厂)都愿意下注的方向。
而时间线更有意思: OpenCPX 作为标准文档刚刚发布,基于同类思路的实物已经在云栖展出了。 标准定义的是行业的最小公约数,能把实物跑在标准前面,说明这台机器不是照着文档攒的 demo,而是文档反过来追上了工程实践。对做标准的人来说,这是最舒服的位置——你不用说服别人”这在理论上可行”,你只需要指着展台说”它在跑”。
当然,我也要把话说全:IPO 实物和 OpenCPX Type-1 是”思路高度重合”,不等于”符合 OpenCPX 规范”。展出的机器用的是阿里云牵头的 UPO 体系,两个标准的接口定义、公差和测试方法是否互通,要等文本细节对齐之后才知道。现阶段可以下的判断只有一个: 解耦这条路,东西方走到了同一个路口。
6. UPO:不押注形态,押注接口
那 UPO 是什么?和 IPO、OpenCPX 又是什么关系?
UPO(Ultra Performance Optics,超高性能光模块)是阿里云联合腾讯牵头、在 ODCC(开放数据中心委员会)制定的标准,V1.0 已在 2026 年 8 月正式发布。它管的不是”光引擎摆在哪”这一个形态问题,而是一整套接口:
- 性能:单通道 224G,单模组 6.4T/7.2T,并预留了向 448G/lane、12.8T/14.4T 演进的能力;连接器本体(UPO XD)的测试数据显示向 448G 平滑演进可行;
- 灵活性:三种产品类型覆盖最高密度、均衡设计、集成光源等场景;四种与主芯片的集成方式——On-PCB、On-Substrate、Over-Substrate、On-CoWoP。注意这个列表:从传统 PCB 到封装基板上,UPO 把 NPO 和 IPO 类的近芯片形态都收进了同一套接口定义, 它不押注形态,押注的是”无论形态怎么变,模组接口不变”;
- 可靠性与可维护性:第 4.4 节讲的那些机械设计(定位 PIN、独立压块、无焊接、Detachable FAU)都写进了标准。
云栖展出的 6.4T UPO 光模块,就是按这套标准、用阿里自研硅光芯片实现的。
为什么我特别看重”把可靠性写进标准”这件事?因为高速互连行业的历史反复证明: 性能指标大家都会卷,最后拉开差距的是公差链、压力窗口、热循环寿命这些没人愿意在发布会上讲的脏活。 把它们标准化,等于把”某个工程师的手艺”变成”全行业的地板”。
生态名单也值得一提:UPO 的参与方覆盖了阿里、腾讯、快手、美团等云厂商,锐捷、华为、华三、中兴等设备商,以及 TE、Samtec、Molex、立讯、安费诺这些连接器大厂。连接器三巨头同时出现在名单里,说明第 4.4 节那个”关键高速器件”的判断,产业界是认账的。
7. 这条链是一层层做出来的
我为什么愿意相信云栖这台 IPO 交换机不是 PPT?因为链条是连续的。
阿里公开的自研硅光芯片覆盖 400G、800G、1.6T 三档,已经批量部署。往下走是 3.2T NPO 模块:22.5mm × 35.1mm 的尺寸里塞进 3.2Tb/s,用两颗 16 通道收发一体硅光芯片,配线性直驱的 Driver/TIA,2D flip-chip 封装,走 OIF 标准的 LGA socket,光源用 OIF ELSFP 外置。模块级典型 TDECQ 1.9dB,接收端在 1E-6 误码率下所有通道灵敏度优于 -5dBm,典型功耗约 20W。
再往下是整机:四颗 25.6T 国产交换芯片,配 32 个 3.2T NPO 模组和 32 个 ELSFP 外置光源,内部做 Shuffle 组网,对外呈现 256 × 400G DR4(500m)的标准形态——用户运维习惯不用改。整机 TP2 光眼图 TDECQ 2.3dB,已通过跌落、振动等可靠性测试,具备批量部署条件。
然后才是 6.4T UPO 标准(ODCC V1.0 发布),和云栖这台 IPO 交换机。
从芯片,到模块,到整机,到标准,到新形态——每一层都有可验证的东西交出来。 这比任何”我们领先”的表述都有说服力。
顺带说一句,模块级 TDECQ 1.9dB 和整机 TP2 的 2.3dB 这两个数字对不上,不是数据打架:前者是模块出厂测试点,后者是整机上的实际测试点,中间多了连接器和系统级的一切。 能把这两个数都公开出来,本身就说明测试是认真做的。 全部放在一起看,也说明这支队伍在 光互联上的积累不是从这台机器才开始的。
8. 最后说点工程上的事
跳出这台交换机,我想说一个更大的判断。
过去十年,高速互连的演进叙事基本是”更快”:10G、25G、56G、112G、224G。但 224G 之后,行业的主要矛盾变了—— 不再是单点速率做不做得出来,而是做出来之后,系统层面的可维护性、良率、供应链和演进节奏还撑不撑得住。 IPO 跳过 BGA、OpenCPX 拆分 RF/MP socket、UPO 把公差链写进标准,这三件事表面上分属三个组织、两个半球,回答的却是同一个问题。
这里面有一种我很认可的做事方式: 不赌单一形态,把接口做开放,把可靠性做扎实,然后让时间和量产去投票。 押注 CPO 的厂商赌的是”焊死之后所有问题都能在封装内解决”;押注解耦的厂商赌的是”激光器的失效率不会一夜之间归零,运维的账永远要算”。我站后者,因为后者的假设更弱——它不需要物理学进步,只需要工程学不退步。
对做基础设施的工程师来说,这里面还有一层职业上的启发: 下一代互连的竞争,一半在 SerDes 和 PIC 里,另一半在连接器的公差链里。 前者出论文,后者出可靠性。愿意蹲下来算公差、做热循环、抠 0.05mm 平整度的团队,最后拿走的是批量部署。
9. 附录:本文术语表
| 术语 | 全称 | 释义 |
|---|---|---|
| FRO/LPO | (Fully) Retimed / Linear Pluggable Optics | 前面板可插拔光模块;FRO 带 DSP 重定时,LPO 为线性直驱(去 DSP) |
| XPO | eXtra-dense Pluggable Optics | Arista 牵头的 12.8T 级高密液冷可插拔模块 MSA 标准 |
| NPO | Near-Packaged Optics | 近封装光学:光引擎移到主芯片附近的 PCB 上,经 socket 可拆连接 |
| IPO | InterPoser Optics | 在主芯片旁引入高密 interposer 连接器,高速信号从封装基板上层直接引出,光电器件部署在 interposer 上且可拆 |
| CPO | Co-Packaged Optics | 共封装光学:光引擎与 ASIC 合封在同一封装体系内,不可拆 |
| CPC / ICA | Co-Packaged Copper / Interposer Copper Attach | 与 CPO/IPO 对应的铜缆形态:高速铜缆从封装旁连接器直接引出 |
| UPO | Ultra Performance Optics | 阿里云联合腾讯牵头、ODCC 发布的超高性能光模块标准,V1.0 于 2026 年 8 月发布 |
| OpenCPX | Open CPX | Open CPX MSA 发布的 co-packaged 解耦接口标准,v1.0 于 2026 年 9 月发布 |
| ODCC | 开放数据中心委员会 | 国内数据中心标准组织 |
| OIF | Optical Internetworking Forum | 光互连论坛,制定 LGA socket、ELSFP 等接口规范 |
| interposer | — | 中介层:位于芯片封装与模组之间的高密布线/连接载体 |
| BGA | Ball Grid Array | 芯片封装底部的焊球阵列,高速信号的传统逃逸路径 |
| LGA | Land Grid Array | 平面触点阵列 socket,靠压力接触、可拆 |
| substrate | 封装基板 | 芯片封装内 die 与 BGA 之间的布线层 |
| PAM4 | 4-level Pulse Amplitude Modulation | 四电平调制,224G/lane 的主流调制格式 |
| SerDes | Serializer/Deserializer | 芯片高速串行收发接口 |
| TDECQ | Transmitter Dispersion Eye Closure Quaternary | PAM4 光发射端眼图质量指标,越小越好 |
| TP2 | Test Point 2 | 整机/模块光输出测试点 |
| ELS / ELSFP | External Laser Source (SFP) | 外置激光源及其可插拔封装形态,把易损激光器移出高温区、独立维护 |
| FAU / DFAU | Fiber Array Unit / Detachable FAU | 光纤阵列单元;DFAU 为可插拔形态,便于光纤侧维护 |
| CTE | Coefficient of Thermal Expansion | 热膨胀系数,异质材料界面热循环应力的来源 |
| fretting corrosion | 微动磨损腐蚀 | 接触面微小相对位移导致氧化膜反复破坏再生,产生接触电阻噪声 |
| Scale-Up / Scale-Out | — | 前者指超节点内 GPU/xPU 高带宽互连,后者指集群间网络 |
| linear drive | 线性直驱 | 去掉 DSP 重定时、电接口线性透传的光模块架构,低功耗低时延,但对电通道质量要求高 |